
當線上服務發出重大警報時,SRE(網站可靠性工程師)需要同時排查多個系統:找應用程式錯誤日誌、調閱 Prometheus 效能指標,以及檢查最近是否有新的版本發布。
如果將這些工作全部交給同一個 Agent,模型在讀取上萬行日誌後,Context 會被大量的錯誤堆疊(Stacktrace)淹沒,後續推論指標突變時間點時極易產生幻覺或遺漏細節。此外,日誌搜尋、監控指標查詢與發布紀錄查詢這三類工具的查詢語法和參數格式各不相同,全部配置給單一 Agent,模型容易把某個工具的參數填到另一個工具上。
這是一個標準的 Orchestrator-Subagent(協調者—子代理) 場景:由主導的 Orchestrator 負責平行派發任務,三個專門的 Sub-Agent 在各自乾淨的 Context 內完成排查並提煉出簡短摘要,最後由 Orchestrator 彙整並推論出根本原因。
對應的範例程式位於 langgraph-orchestrator-sre。models.py 定義 Sub-Agent 的輸出契約與 Orchestrator State,subagents.py 放三個 Sub-Agent 與匯流推論的函式,mock_data.py 提供模擬的日誌、指標與發布紀錄,workflow.py 組裝 Graph,main.py 則是 uv run sre-orchestrator 的進入點。
系統收到一則來自 Alertmanager 的警報:CheckoutService 500 Error Surge & P99 Latency Spike(結帳服務的 500 錯誤率暴增,且 P99 延遲飆破 4500ms)。
面對這類重大效能與錯誤事故,SRE 需要同時從三個互不重疊的維度展開排查,因此我們切分出三個專門的 Sub-Agent:
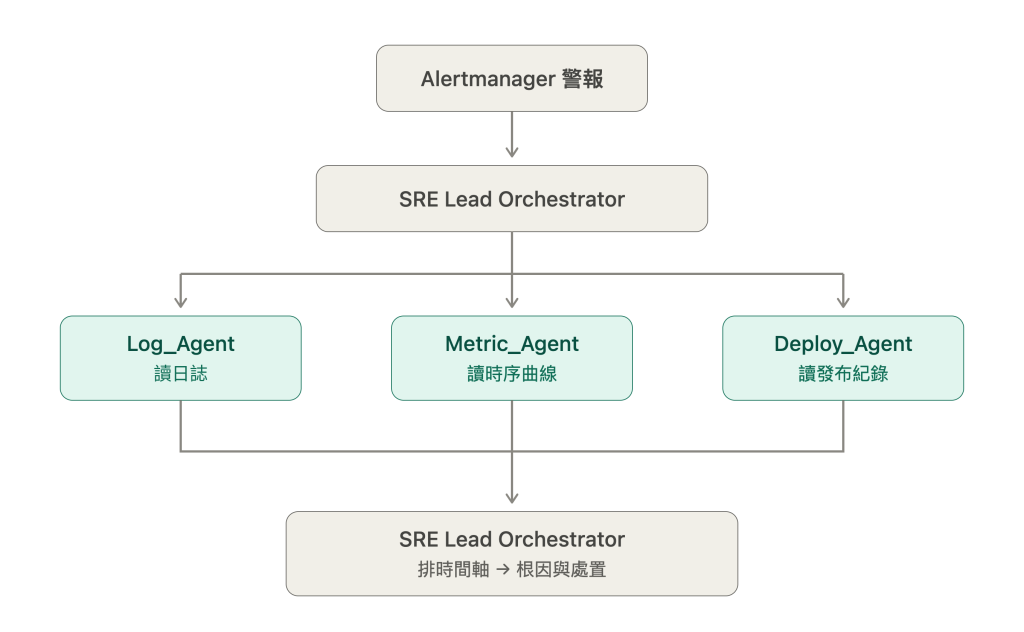
Log_Agent(查錯誤現象與代碼位置):當服務拋出 500 錯誤時,需要知道具體是哪一段程式碼或下游連線拋出 Exception。Log_Agent 負責翻閱應用程式日誌,找出核心錯誤特徵(Error Signature)、錯誤堆疊(Stacktrace)與首次報錯的時間點。Metric_Agent(查系統瓶頸與資源狀態):當延遲飆高時,單看日誌無法看出系統哪裡塞車。Metric_Agent 負責查詢 Prometheus 時序指標,比對 CPU、記憶體與資料庫連線池(DB Connection Pool)的使用率,確認哪一項基礎設施指標最先發生突增(Spike)。Deploy_Agent(查環境變更與發布事件):線上突發的異常通常與近期的版本發布或設定異動有關。Deploy_Agent 負責調閱 Jenkins Pipeline 與 Git 紀錄,確認近 2 小時內是否有新版本上線、生效時間點與具體變更的 Commit 摘要。為了避免子代理將未經整理的長文倒回主流程,所有 Sub-Agent 的輸出必須符合明確的 Pydantic 契約:
from typing import Literal
from pydantic import BaseModel, Field


class LogFinding(BaseModel):
    """日誌分析 Sub-Agent 的結果契約。"""
    error_signature: str = Field(description="核心錯誤特徵與發生位置")
    error_count: int = Field(description="錯誤發生次數")
    first_seen_time: str = Field(description="首次出現時間點,格式 HH:MM:SS")
    sample_message: str = Field(description="代表性的錯誤訊息片段")


class MetricFinding(BaseModel):
    """指標分析 Sub-Agent 的結果契約。"""
    anomaly_detected: bool = Field(description="是否偵測到異常指標")
    p99_latency_ms: float = Field(description="當前 P99 延遲(毫秒)")
    spike_time: str = Field(description="指標突變時間點,格式 HH:MM:SS")
    root_metric_clue: str = Field(description="異常指標特徵(如 connection pool saturation)")


class DeployFinding(BaseModel):
    """發布分析 Sub-Agent 的結果契約。"""
    has_recent_deploy: bool = Field(description="近 2 小時內是否有發布事件")
    service_version: str = Field(description="當前部署的版本號")
    deployed_at: str = Field(description="發布生效時間點,格式 HH:MM:SS")
    suspect_commit_summary: str = Field(description="可疑 Commit 摘要")


class IncidentDiagnosis(BaseModel):
    """Orchestrator 最終產出的診斷報告。"""
    root_cause_summary: str = Field(description="事故根本原因摘要")
    confidence_level: Literal["HIGH", "MEDIUM", "LOW"] = Field(description="診斷信心度")
    recommended_action: Literal["ROLLBACK", "SCALE_UP", "RESTART_POD", "ESCALATE_HUMAN"] = Field(
        description="建議處置動作"
    )
    timeline_analysis: str = Field(description="事件因果時序推論")
每個 Sub-Agent 擁有專屬的 System Prompt 與獨立的 Context。
Log_Agent 配備日誌查詢工具。它在獨立 Context 中檢索日誌並抽取代表性錯誤,主流程完全不會接觸到原始的文字:
from langchain_anthropic import ChatAnthropic
from langchain_core.prompts import ChatPromptTemplate

llm = ChatAnthropic(model="claude-haiku-4-5", temperature=0.0)


from pathlib import Path


def read_raw_logs(service_name: str) -> str:
    """從日誌檔案(如 Loki / Elasticsearch 匯出的 log 檔)讀取原始日誌。"""
    log_path = Path(f"data/{service_name.lower().replace('-', '_')}.log")
    if not log_path.exists():
        log_path = Path("data/checkout_service.log")
    return log_path.read_text(encoding="utf-8")


def run_log_agent(service_name: str) -> LogFinding:
    raw_logs = read_raw_logs(service_name)

    prompt = ChatPromptTemplate.from_messages([
        (
            "system",
            "你是 SRE 日誌分析專家。請閱讀原始日誌,找出最主要且具代表性的錯誤特徵,"
            "提煉為精簡的結構化結果,不要回傳多餘的日誌行。"
        ),
        ("human", "請分析 {service_name} 的錯誤日誌:\n\n{logs}")
    ])

    extractor = llm.with_structured_output(LogFinding)
    chain = prompt | extractor
    return chain.invoke({"service_name": service_name, "logs": raw_logs})
Metric_Agent 配備 Prometheus 指標查詢工具,專門比對 P99 延遲與連線池使用率:
def run_metric_agent(service_name: str) -> MetricFinding:
    # 模擬 Prometheus 查詢結果
    metric_data = "Checkout latency p99 jumped to 4500ms at 13:20:00. DB Pool usage reached 100% at 13:20:00."

    prompt = ChatPromptTemplate.from_messages([
        (
            "system",
            "你是 SRE 指標分析專家。請分析 Prometheus 時序資料,標註延遲突增時間點與可疑指標。"
        ),
        ("human", "請分析 {service_name} 的指標數據:\n\n{metric_data}")
    ])

    extractor = llm.with_structured_output(MetricFinding)
    chain = prompt | extractor
    return chain.invoke({"service_name": service_name, "metric_data": metric_data})
Deploy_Agent 負責比對 Git Commit 與 Jenkins 發布時間點:
def run_deploy_agent(service_name: str) -> DeployFinding:
    # 模擬 Jenkins Pipeline / Git 查詢結果
    deploy_data = "Jenkins Pipeline deploy-checkout-service #142 (v2.14.0) completed at 13:18:00. Commit: 'fix: retry connection pool without timeout'"

    prompt = ChatPromptTemplate.from_messages([
        (
            "system",
            "你是 SRE 發布審查專家。請分析近期的部署事件與 Commit 內容。"
        ),
        ("human", "請分析 {service_name} 的發布事件:\n\n{deploy_data}")
    ])

    extractor = llm.with_structured_output(DeployFinding)
    chain = prompt | extractor
    return chain.invoke({"service_name": service_name, "deploy_data": deploy_data})
在 LangGraph 中,Orchestrator 透過平行 Fan-out 同時啟動三個 Sub-Agent 節點,並在聚合節點(Join)中接收三個結構化結果。我們可以分四個步驟組裝整個流程:
主圖的 State 負責保存輸入的事故警報、各 Sub-Agent 產出的結構化結果,以及最終診斷報告:
from typing import TypedDict
from langgraph.graph import StateGraph, START, END


class OrchestratorState(TypedDict):
    service_name: str
    incident_alert: str
    log_finding: LogFinding | None
    metric_finding: MetricFinding | None
    deploy_finding: DeployFinding | None
    final_diagnosis: IncidentDiagnosis | None
每個 Worker 節點只負責呼叫專屬的 Sub-Agent,並把提煉後的 Pydantic 契約寫回 State。各節點的執行彼此獨立,互不影響:
def log_subagent_node(state: OrchestratorState):
    finding = run_log_agent(state["service_name"])
    return {"log_finding": finding}


def metric_subagent_node(state: OrchestratorState):
    finding = run_metric_agent(state["service_name"])
    return {"metric_finding": finding}


def deploy_subagent_node(state: OrchestratorState):
    finding = run_deploy_agent(state["service_name"])
    return {"deploy_finding": finding}
聚合節點(synthesizer)是整個主從架構的決策核心。它讀取三個已完成的結構化結果,將時間戳記與現象進行因果交叉比對(Timeline Analysis),並輸出最終的 IncidentDiagnosis 報告:
def synthesize_diagnosis_node(state: OrchestratorState):
    """Orchestrator 匯流節點:接收 3 個乾淨摘要並推論根本原因。"""
    prompt = ChatPromptTemplate.from_messages([
        (
            "system",
            "你是 SRE Lead 事故協調專家。請根據各 Sub-Agent 提供的分析結果,"
            "交叉比對事件時間序(Timeline),找出根本原因並給出處置建議。"
        ),
        (
            "human",
            "事故警報:{alert}\n\n"
            "1. 日誌分析結果:{log_res}\n\n"
            "2. 指標分析結果:{metric_res}\n\n"
            "3. 發布分析結果:{deploy_res}\n\n"
            "請進行因果推論並產出最終處置報告。"
        )
    ])

    synthesizer = llm.with_structured_output(IncidentDiagnosis)
    chain = prompt | synthesizer

    diagnosis = chain.invoke({
        "alert": state["incident_alert"],
        "log_res": state["log_finding"].model_dump_json() if state["log_finding"] else "無數據",
        "metric_res": state["metric_finding"].model_dump_json() if state["metric_finding"] else "無數據",
        "deploy_res": state["deploy_finding"].model_dump_json() if state["deploy_finding"] else "無數據",
    })

    return {"final_diagnosis": diagnosis}
我們使用 LangGraph 的邊(Edge)定義執行流向:
START 同時連出三條邊到 log_worker、metric_worker 與 deploy_worker,LangGraph 會並行排程這三個節點。synthesizer。LangGraph 會自動等待所有並行分支皆執行完畢,才觸發 synthesizer 節點。builder = StateGraph(OrchestratorState)
# 註冊 4 個節點
builder.add_node("log_worker", log_subagent_node)
builder.add_node("metric_worker", metric_subagent_node)
builder.add_node("deploy_worker", deploy_subagent_node)
builder.add_node("synthesizer", synthesize_diagnosis_node)
# 平行 Fan-out:從 START 同時連到三個 worker
builder.add_edge(START, "log_worker")
builder.add_edge(START, "metric_worker")
builder.add_edge(START, "deploy_worker")
# 匯流 Join:三個 worker 完成後進入 synthesizer
builder.add_edge("log_worker", "synthesizer")
builder.add_edge("metric_worker", "synthesizer")
builder.add_edge("deploy_worker", "synthesizer")
builder.add_edge("synthesizer", END)
sre_graph = builder.compile()
在範例專案目錄設定 ANTHROPIC_API_KEY 後,執行 uv run sre-orchestrator:
cd note-code/agent/langgraph/langgraph-orchestrator-sre
uv sync
export ANTHROPIC_API_KEY="..."
uv run sre-orchestrator
main.py 做的事等同於對編譯好的 Graph 傳入事故警報:
initial_input = {
    "service_name": "CheckoutService",
    "incident_alert": "P99 latency > 4000ms & 500 error rate > 15%",
    "log_finding": None,
    "metric_finding": None,
    "deploy_finding": None,
    "final_diagnosis": None,
}

result = sre_graph.invoke(initial_input)
diagnosis = result["final_diagnosis"]

print(f"根因摘要: {diagnosis.root_cause_summary}")
print(f"處置動作: {diagnosis.recommended_action}")
print(f"信心程度: {diagnosis.confidence_level}")
print(f"時序分析:\n{diagnosis.timeline_analysis}")
根因摘要: 13:18 發布的 v2.14.0 版本修改連線池邏輯,導致 13:20 連線池耗盡,隨後引發支付閘道連線逾時與 NullPointerException。
處置動作: ROLLBACK
信心程度: HIGH
時序分析:
- 13:18:00 服務發布 checkout-service:v2.14.0(修改連線池重試邏輯)。
- 13:20:00 Prometheus 偵測到 DB 連線池使用率達 100%,P99 延遲同步飆升至 4500ms。
- 13:21:02 日誌開始大量出現 ConnectionPoolExhaustedException 與 NPE。
- 結論:發布變更為確切根因,建議立即 Rollback 至 v2.13.9。


 iThome鐵人賽
 看影片追技術